Saltar al contenido

Hogar conectado · Asistente de voz con IA

Jarvis, asistente de voz para el hogar

Jarvis es el asistente de voz que desarrollamos y usamos a diario en una vivienda con Home Assistant. Es nuestro banco de pruebas real para lo que luego aplicamos a asistentes y agentes: latencia medida, respaldo entre proveedores y modelos que no pueden inventarse una acción.

Tipo
Producto propio
Sector
Hogar conectado
Solución
Asistente de voz con IA
Periodo
Desde julio de 2026
Estado
En producción En uso diario en una vivienda

Resumen ejecutivo

Asistente de voz para una casa con Home Assistant: palabra de activación propia, órdenes resueltas en código y cuatro proveedores de LLM con respaldo.

Jarvis escucha en el salón con un micrófono de conferencia y en otras estancias a través de satélites de voz de Home Assistant. Detecta su palabra de activación con un modelo propio de openWakeWord, transcribe con Deepgram y con Whisper local de reserva y resuelve en código las órdenes habituales: luces por habitación, clima, sensores, temporizadores, recordatorios o la lista de la compra. Lo demás pasa a una cadena de cuatro proveedores de LLM con respaldo automático. Guarda conversaciones y hechos en PostgreSQL y Qdrant, habla con ElevenLabs y voces locales de reserva y se usa también desde una PWA y un panel web.
El reto

  1. Un asistente que vive en una casa tiene que contestar rápido, entender castellano con la tele de fondo y no quedarse mudo cuando falla un servicio en la nube.

  2. La palabra de activación preentrenada acertaba la mitad de las veces o se disparaba sola varias veces por hora, y la televisión provocaba cientos de activaciones al día.

  3. La transcripción en la nube llegó a tardar 6,5 segundos y a confundir el castellano con sueco, inglés o portugués.

  4. Además, un modelo de lenguaje no puede encender ni apagar nada que nadie ha pedido, ni contestar a «¿está encendida la luz?» ejecutando una orden.

La solución

Un servicio de voz en Python que funciona 24 horas en un mini PC con Debian, junto a Home Assistant en Docker. Las órdenes de la casa se resuelven en código y solo el resto llega al modelo de lenguaje. Cada pieza crítica tiene suplente: tres motores de transcripción, cuatro proveedores de LLM y tres voces. Los modelos solo actúan mediante herramientas con lista blanca, validadas contra los aparatos reales de la casa.

Funcionalidades

Qué hace, pantalla a pantalla

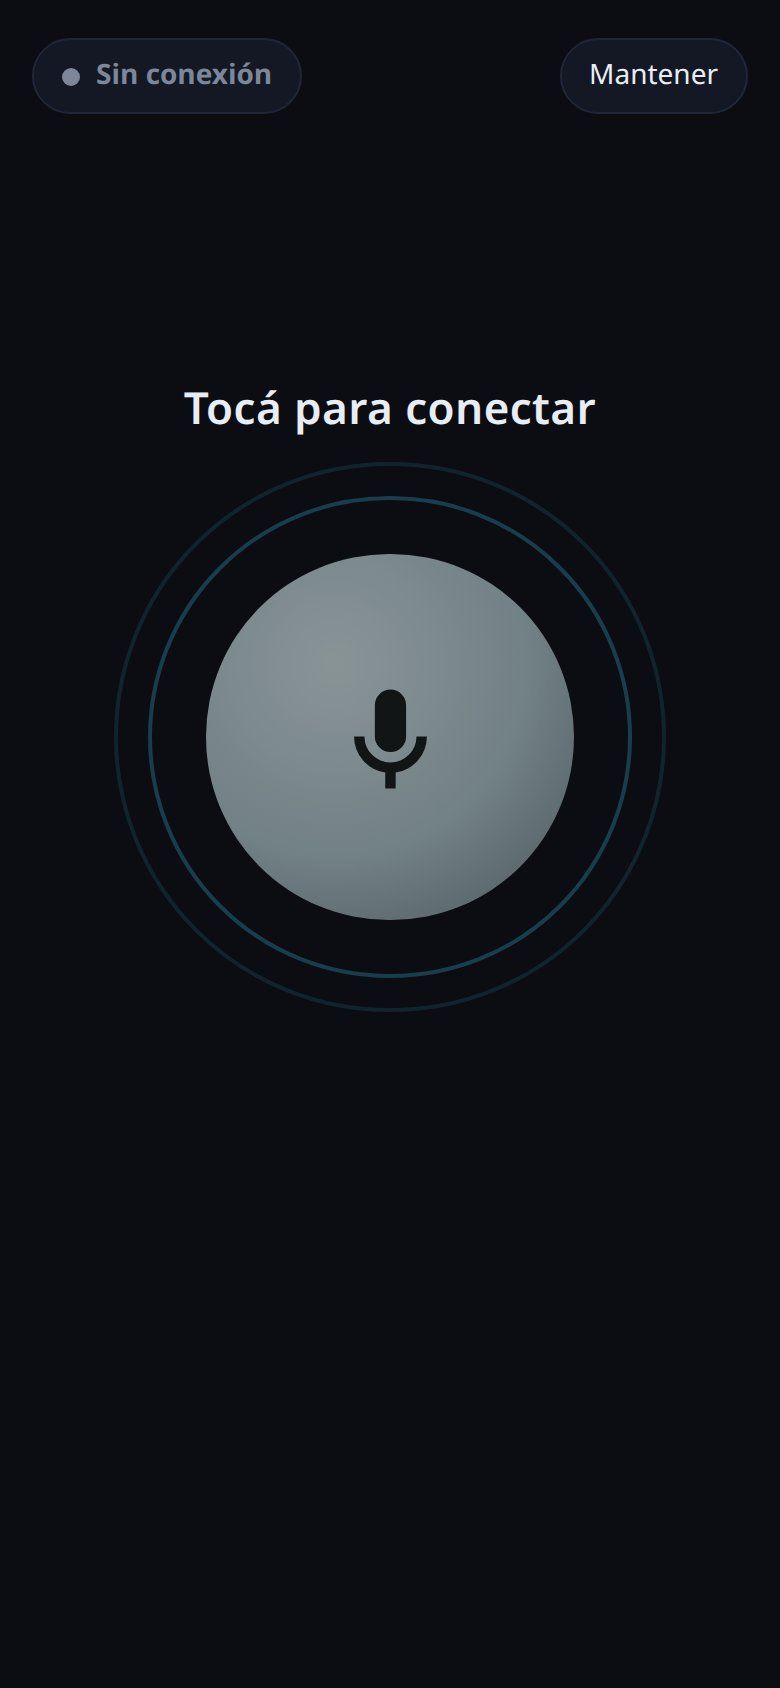
Pantalla de la PWA móvil de Jarvis en reposo, con el indicador «Sin conexión», el modo «Mantener» y el botón de micrófono para empezar a hablar.

01

Satélites, PWA móvil y panel web

Los satélites de voz de otras estancias llegan al mismo cerebro mediante un puente HTTP. En el móvil, una PWA abre una sesión voz a voz con una clave efímera, y un panel FastAPI con HTMX muestra conversaciones, hechos y eventos.

  • Palabra de activación entrenada en casa

    Un modelo propio de openWakeWord, evaluado sobre un examen congelado de grabaciones reales, con una compuerta de energía que descarta el silencio digital del micrófono. Un agente reentrena el modelo con los aciertos y fallos que deja el uso.

  • Órdenes resueltas en código

    Luces por habitación con excepciones («todas salvo la del sofá»), clima, sensores, temporizadores, recordatorios, tele, volumen y lista de la compra se resuelven sin modelo de lenguaje. Las frases con varias órdenes se separan y un contador mide qué parte acaba en el LLM.

  • Interpretación flexible con lista blanca

    Las órdenes ambiguas, como «una luz tranquila para cenar», las traduce un modelo pequeño a acciones con salida estructurada. Cada acción se valida contra las entidades reales, con un máximo de cuatro por frase. Accesos y cerraduras quedan fuera de este camino.

  • Cadena de modelos con respaldo

    Un proveedor titular configurable y tres suplentes automáticos entre Groq, OpenAI, Anthropic y Ollama en local, con un plazo para toda la cadena. Si un proveedor retira un modelo, el fallo se detecta y la respuesta sigue por el siguiente.

  • Voz con respaldo local

    ElevenLabs en streaming por oraciones, de modo que empieza a hablar con la primera frase; si falla o se agota el cupo, Kokoro y Piper en local. Tras una orden consulta Home Assistant para confirmar que el cambio ocurrió de verdad.

  • Conversación voz a voz

    Modo en vivo con OpenAI Realtime o Gemini Live después de la palabra de activación. La respuesta solo suena si la transcripción propia confirma que alguien hablaba, y las herramientas pasan por los mismos guardias que el resto del asistente.

  • Memoria de conversaciones y documentos

    Conversaciones, hechos y eventos de la casa en PostgreSQL y en Qdrant, con embeddings multilingües calculados en local. Cada hora un resumidor extrae hechos nuevos, y se pueden indexar documentos PDF, Markdown o texto para consultarlos después.

  • Agentes en segundo plano

    Diez agentes y un resumidor funcionan como servicios de systemd: avisos proactivos con silencio nocturno y tope diario, registro de eventos de la casa, monitor de recursos, lectura solar, puente de presencia y entrenador de la palabra de activación, entre otros.

Cómo funciona

Del micrófono a la respuesta

  1. Activación

    openWakeWord evalúa el audio cada 80 ms con el modelo propio. Una compuerta de energía descarta los disparos sobre silencio digital antes de abrir la escucha.

  2. Fin de turno

    Silero VAD, combinado con el volumen, decide cuándo has terminado de hablar. En la primera pausa se lanza una transcripción especulativa para ganar tiempo en las órdenes cortas.

  3. Transcripción

    Deepgram con términos clave de la casa va primero; Whisper local en CPU y OpenAI quedan de reserva. Se filtran alucinaciones, bucles y frases en otro idioma.

  4. Enrutado

    Los manejadores en código resuelven luces, clima, sensores, temporizadores, recordatorios y lista de la compra. Las órdenes ambiguas van al intérprete con lista blanca.

  5. Respuesta abierta

    El resto va a la cadena de LLM con memoria y, si hace falta, búsqueda web con un presupuesto de 6 segundos. Mientras piensa, una muletilla breve tapa la espera.

  6. Voz y confirmación

    La respuesta se sintetiza por oraciones con ElevenLabs, Kokoro o Piper. Tras una orden se consulta Home Assistant y, si el cambio no se observa, lo dice en vez de darlo por hecho.

  7. Memoria

    La conversación se guarda en PostgreSQL y Qdrant, y el resumidor horario convierte lo importante en hechos que se recuperan en las siguientes preguntas.

Arquitectura

Cómo está construido

Plano · jarvis 6 capas · 22 piezas
  1. Entradas y clientes

    • Micrófono de conferencia USB en el salón
    • Satélites de voz de Home Assistant por estancia
    • PWA móvil con voz por WebRTC
    • Panel web y Alexa
    • De Entradas y clientes a Pipeline de voz: audio y texto
  2. Pipeline de voz

    • openWakeWord con modelo propio y compuerta de energía
    • Silero VAD y transcripción especulativa
    • Deepgram, faster-whisper local y OpenAI
    • Manejadores en código e intérprete con lista blanca
    • ElevenLabs, Kokoro y Piper
  3. Servicios

    • Puente de satélites y servicio móvil en FastAPI
    • Panel FastAPI, Jinja2 y HTMX
    • Diez agentes y un resumidor en systemd
    • Contador de enrutado y medición de latencias
  4. Modelos de lenguaje

    • Groq, OpenAI, Anthropic y Ollama local
    • OpenAI Realtime y Gemini Live
    • Búsqueda web con Tavily y DuckDuckGo
  5. Datos

    • PostgreSQL 16
    • Qdrant con embeddings de 384 dimensiones (sentence-transformers)
    • Mosquitto (MQTT)
  6. Casa

    • Home Assistant en Docker
    • Mini PC con Debian y systemd
    • Copias con manifiesto y verificación

Otros flujos

  • Pipeline de voz → Modelos de lenguaje : lo que no es una orden
  • Pipeline de voz → Casa : órdenes validadas
  • Servicios → Datos : conversaciones, hechos y eventos
  • Casa → Servicios : estados y avisos por MQTT
  • Modelos de lenguaje → Pipeline de voz : respuesta en streaming

Tecnologías

Stack verificado en el código

Interfaz

  • HTMX
  • PWA

Backend

  • Python
  • FastAPI

Datos

  • PostgreSQL
  • Qdrant

IA y voz

  • sentence-transformers
  • openWakeWord
  • Whisper
  • Piper TTS
  • ElevenLabs
  • Ollama
  • OpenAI API
  • Groq
  • Claude (Anthropic)
  • Google Gemini
  • Deepgram

Infraestructura

  • Docker
  • Linux

IoT, domótica y 3D

  • Home Assistant
  • MQTT (Mosquitto)

Calidad

  • pytest

Ingeniería

Cómo se planteó y se construyó

  1. Auditoría y latencia (julio de 2026)

    El trabajo arranca a mediados de julio de 2026 con una auditoría del sistema y la medición de cada etapa de la voz. Silero VAD sustituye al corte por volumen, se separan los plazos de conexión y de respuesta de Ollama y cada respuesta registra qué proveedor la dio.

  2. Proveedores medidos (finales de julio de 2026)

    Llega ElevenLabs con streaming y doble respaldo local, se comparan los LLM con el prompt real midiendo la primera palabra y se crea el intérprete de órdenes ambiguas en modo sombra, que registra propuestas sin ejecutarlas hasta revisar su acierto.

  3. Mini PC dedicado (agosto de 2026)

    El sistema pasa de un PC con Windows a un mini PC con Debian sin GPU. Una prueba sobre 2.657 grabaciones reales decide la transcripción: Deepgram primero y Whisper small en CPU de reserva. Groq entra de titular y se entrena la nueva palabra de activación.

  4. Voz por habitaciones (septiembre de 2026)

    Un puente conecta los satélites de voz de Home Assistant con el mismo cerebro, con un turno a la vez y plazos por operación. Se añaden avisos por habitación, salud de los satélites y un vigía que reinicia el puente si se cuelga.

  5. Voz a voz, móvil y Alexa (octubre de 2026)

    Llegan el modo en vivo con OpenAI Realtime y Gemini Live, la PWA móvil y la integración con Alexa. Las mejoras de voz se despliegan con copia previa de cada archivo, reversión automática y 2.517 pruebas aprobadas.

Retos técnicos resueltos

Una palabra de activación que acierte casi siempre sin dispararse con la tele.
Cinco rondas de entrenamiento con cambios en los datos no mejoraron al control. El salto vino de una compuerta de energía en el runtime: 84,6 % de acierto a 2,4 falsos positivos por hora. El agente reentrenador se niega a promover un modelo que puntúe peor que el actual.
Que la casa no se quede muda cuando un proveedor de LLM falla o retira un modelo.
Cadena de cuatro proveedores con un plazo global, no por proveedor. Ollama tiene un plazo de conexión de 2 s porque suele estar apagado. Cuando Groq retiró un modelo, el 404 se perdía entre los demás errores; ahora se detecta como modelo retirado y la cadena sigue.
Evitar que el modelo ejecute acciones que nadie ha pedido.
Las herramientas solo corren después de que la transcripción propia autorice el turno. Si la frase era una pregunta de estado, la orden se rechaza; si no es coherente con lo dicho, también. Las acciones se validan contra las entidades reales y los accesos nunca pasan por el modelo.
Transcribir rápido y de forma estable en un equipo sin GPU.
Sobre 2.657 muestras reales, la nube tardaba entre 0,97 y 6,52 s y confundía idiomas; Whisper small en int8 por CPU daba 1,35 s de mediana con poca varianza. Deepgram con términos clave, a 0,68 s de mediana, va primero y el modelo local queda de reserva sin internet.

Resultados

Lo que se ha medido

  • 84,6 %

    de activaciones detectadas a 2,4 falsos positivos por hora, frente al 50 % del modelo preentrenado

    Bitácora de entrenamiento de la palabra de activación (config/wakeword/bitacora_alexa.md), examen congelado de 26 grabaciones reales · 2026-08

  • 276 ms

    hasta la primera palabra del LLM titular, frente a 550 ms del proveedor anterior

    Comparativa con el prompt real (scripts/comparar_llm.py), documentada en justine/llm_client.py · 2026-08

  • 0,75 s

    de grabación mínima tras hablar, frente a 2,10 s con el corte por volumen

    Commit eafedd1 (endpointing con Silero VAD) · 2026-07

  • 2.517

    pruebas automatizadas aprobadas en el despliegue de las mejoras de voz

    Informe de despliegue INFORME_MEJORAS_VOZ.md (commit 70cfcd4, rama voz-integracion) · 2026-10

Latencia hasta la primera palabra por proveedor

Tiempo hasta la primera palabra de la respuesta con el prompt real del asistente. En una conversación hablada es lo que se percibe como rapidez.

Milisegundos hasta la primera palabra: de 276 en Groq Llama 3.3 70B a 850 en OpenAI gpt-5.6-luna.

Fuente: scripts/comparar_llm.py, resultados en justine/llm_client.py (_orden_proveedores) · Datos a 2026-08-09 · Dos rondas de medición desde la red de la casa. Groq retiró después ese modelo y el titular actual es otro de su catálogo, medido en 346 ms en otro proveedor.

Ver los datos en tabla
Latencia hasta la primera palabra por proveedor
Periodo Milisegundos hasta la primera palabra
Groq Llama 3.3 70B 276
Cerebras gpt-oss 346
OpenAI gpt-5.4-nano 550
Gemini Flash-Lite 598
OpenAI gpt-5.6-luna 850

Cronología

Cómo ha evolucionado

  1. Auditoría del sistema, Silero VAD y cadena de proveedores con respaldo.

  2. Paso a un mini PC dedicado y nueva palabra de activación entrenada en casa.

  3. Voz por habitaciones con satélites de Home Assistant.

  4. Conversación voz a voz, PWA móvil e integración con Alexa.

Evolución prevista

Lo siguiente

Trabajo planificado, todavía no disponible.

  1. Previsto · 01

    Memoria de la casa consultable por voz

    Los eventos de la casa ya se indexan en una colección propia de Qdrant. Falta la intención de voz que responda preguntas como «¿cuándo vino el técnico?» con fecha y descripción.

  2. Previsto · 02

    Interrupción por voz en el modo natural

    Hoy el micrófono se silencia mientras habla el asistente para evitar que el eco lo corte. Activar la interrupción requiere antes una prueba acústica en la habitación.

  3. Previsto · 03

    Más satélites según lo medido

    La segunda tanda de satélites de voz se elegirá con los datos de disponibilidad y escucha que ya recoge Home Assistant de la primera.

Proyectos relacionados

Más trabajo en esta línea

Ver todos los proyectos
  • Producto propio En producción

    Plataforma domótica sobre Home Assistant

    Hogar conectado · Domótica e IoT

    Domótica de una vivienda sobre Home Assistant: presencia por habitación con radar y Bluetooth, Zigbee, Shelly y avisos de lo que falla en silencio.

    • Home Assistant
    • ESPHome
    • ESP32
    • Zigbee2MQTT
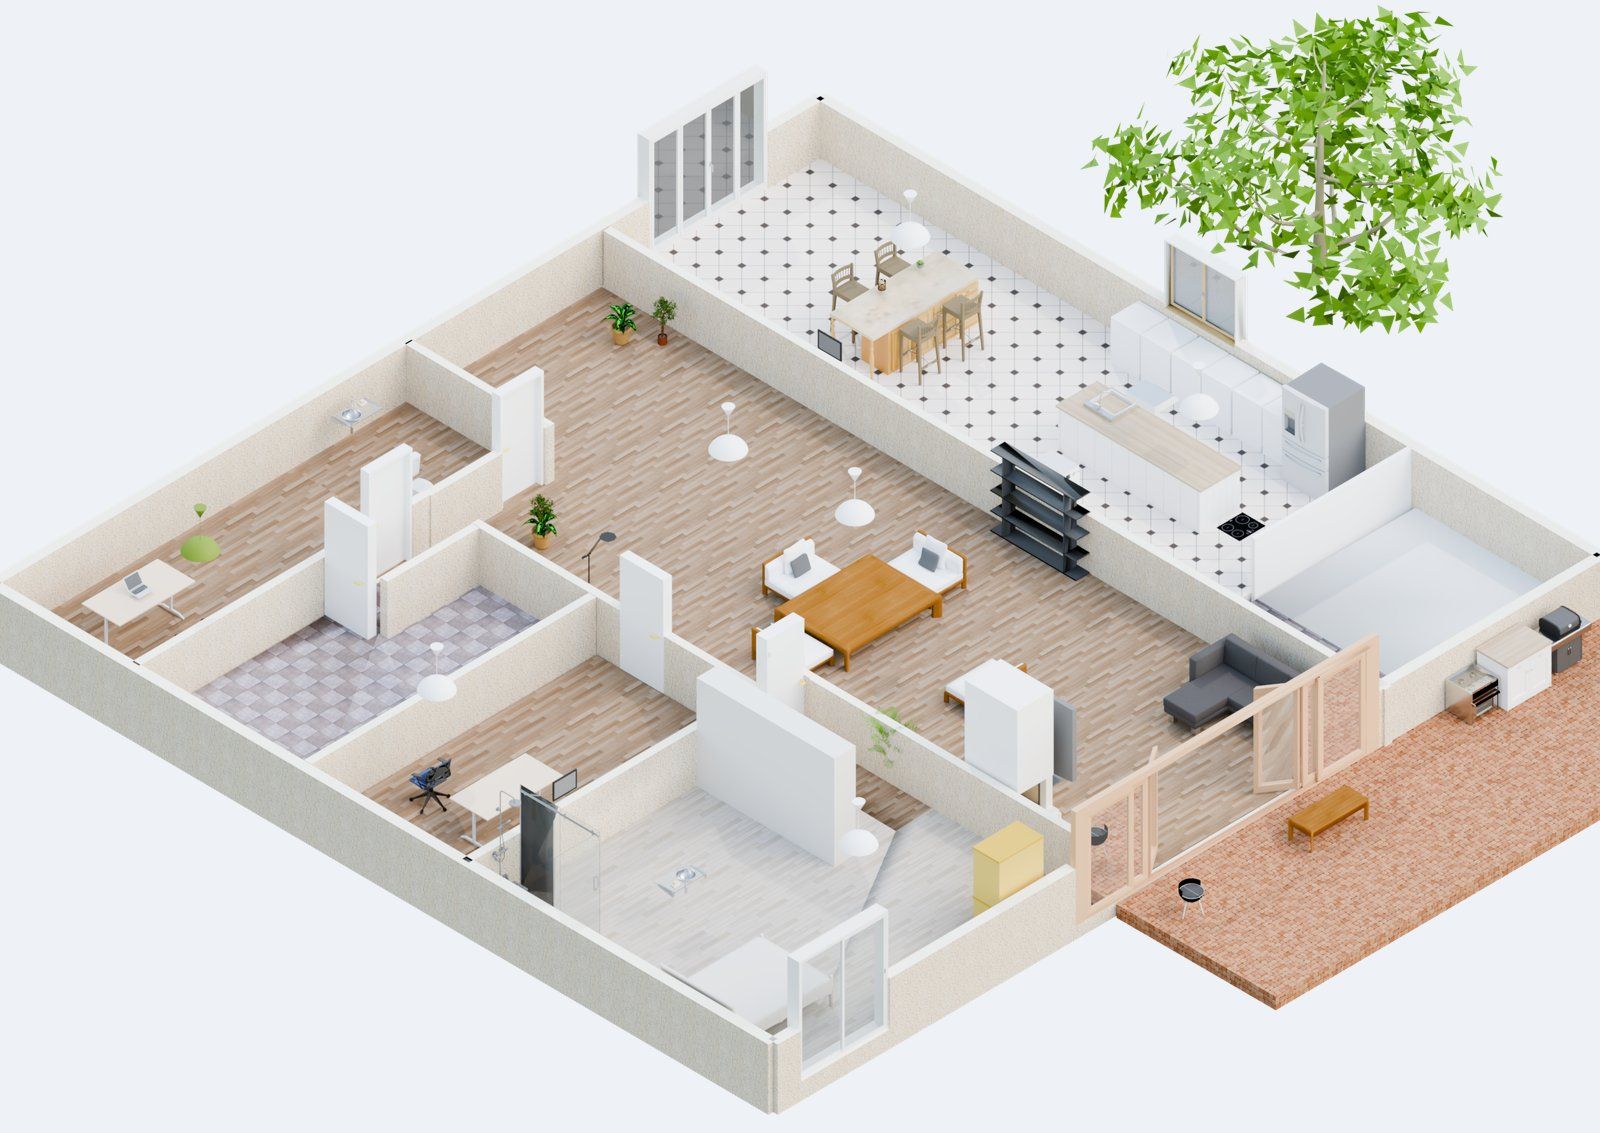
  • Render isométrico de la planta 0 de la vivienda modelada, sin techo, con salón, cocina, dormitorios, baños y terraza amueblados.

    Producto propio En producción

    Gemelo digital 3D de una vivienda

    Hogar conectado · Visualización 3D en tiempo real

    Gemelo 3D navegable de una vivienda dentro de Home Assistant: del plano de Sweet Home 3D a un GLB ligero que muestra luces, energía y estancias en vivo.

    • Sweet Home 3D
    • Blender
    • Python
    • three.js
  • Diseño de producto · simulación Portada de la landing de Smart Sun con el titular «Tu casa, ahora piensa con el sol» y un panel de energía solar con producción, consumo, batería y flujo hacia termo, coche y clima.

    Laboratorio I+D Prototipo

    Smart Sun AI, gestión del autoconsumo solar

    Energía solar residencial · Monitorización y gestión de autoconsumo

    Producto de laboratorio para el autoconsumo solar: la medida y las alertas funcionan en una vivienda; el optimizador que decide está en fase de diseño.

    • Python
    • MQTT (Mosquitto)
    • Home Assistant
    • three.js

Hablemos

¿Necesitas desarrollar una solución similar?

Cuéntanos el problema. Te respondemos con un planteamiento claro: qué haríamos, en cuánto tiempo y con qué entregables.